
정부가 첨단 연산 장비 264장을 중소와 벤처기업에 풀기로 했습니다. 국내에서 가장 비싼 축에 드는 칩인데, 클라우드에 얹어서 제공하고 선정되면 연말까지 무상입니다.
문제는 발표문입니다. "전환 가속화", "초격차", "기술 자립" 같은 말로 가득해서 막상 창업하신 분은 헷갈립니다. 누구한테 주는 건지, 받으면 뭘 만들라는 건지 감이 안 옵니다.
매달 인공지능 서비스에 결제하며 쓰고 계신가요?
그 일을 정부 장비 위로 옮기는 겁니다.
오픈소스 모델을 띄워서 자기만의 창구로 돌리면 됩니다. 새 인공지능을 발명하는 팀이 아니라 이미 나와 있는 걸 자기 업무에 끼워 쓰는 팀을 위한 자원입니다.
정확히 뭐가 풀리는가
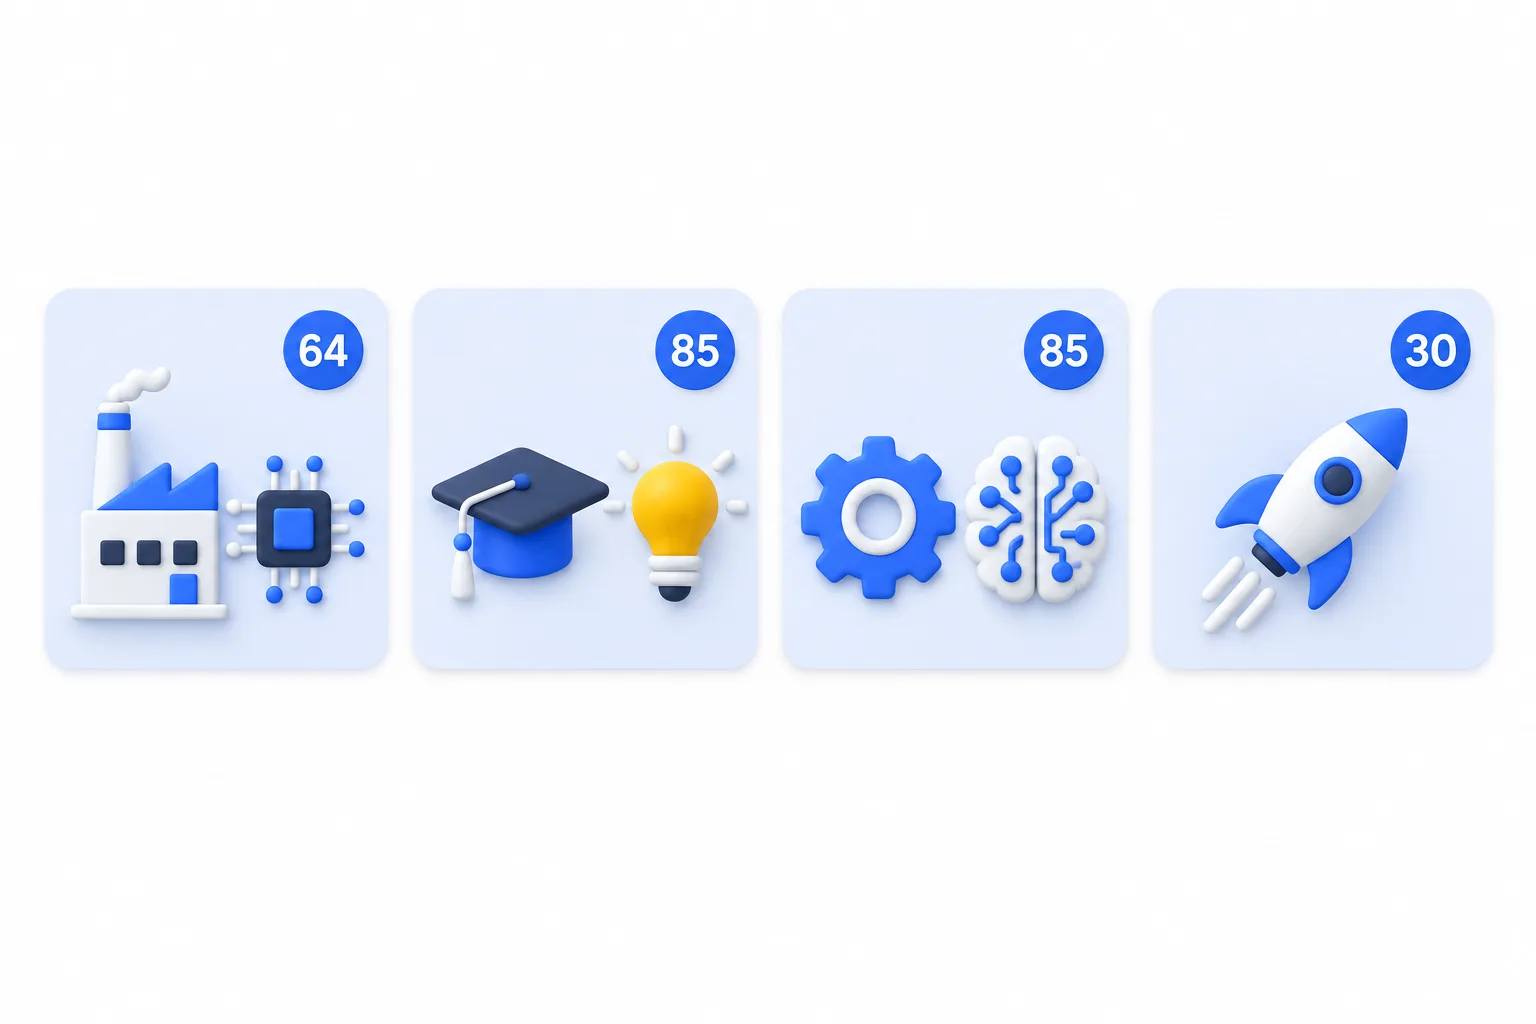
| 갈래 | 수량 | 누가 받나 |
|---|---|---|
| 인공지능 자동화 과제 | 64장 | 기술기업 + 제조기업이 함께 |
| 초격차, 핵심 기술 개발 | 85장 | 대학과 출연연 + 창업기업 협업 |
| 초격차, 산업 특화 | 85장 | 산업 쪽 회사 + 기술 회사가 손잡고 |
| 초격차, 모두의 창업 | 30장 | 해당 사업에 별도 배정 |
여기서 짚고 넘어가야 할 대목이 있습니다. 모든 갈래가 혼자 받는 구조가 아니라 둘 이상이 묶여서 받는 구조라는 점입니다. 기술기업 혼자도, 제조기업 혼자도, 대학 혼자도 안 됩니다. 누구와 짝을 짓느냐가 신청서의 절반을 차지하는 이유입니다.
무엇을 만들라는 건가, 새 인공지능이 아닙니다
가장 많이 헷갈리는 지점부터 바로잡겠습니다. 이 정책은 새 인공지능을 처음부터 학습하라는 뜻이 아닙니다.
널리 쓰이는 모델을 처음부터 학습하려면 장비가 수만 장은 있어야 합니다. 264장으로는 물리적으로 불가능합니다. 정책의 규모 자체가 애초에 응용을 염두에 둔 것입니다.
오픈소스 모델에 자기 회사 문서와 자료를 붙여서 쓰는 방식입니다. 대부분 여기에 해당합니다.
여러 단계를 스스로 밟아 처리하게 만드는 것입니다.
모델 전체가 아니라 일부만 우리 쪽에 맞게 다듬는 것입니다.
전체를 다시 학습시키는 건 극소수에 그칠 전망입니다.
모델은 거의 다 오픈소스를 가져옵니다. 국내에서 많이 쓰는 건 세 갈래로 압축됩니다.
| 이럴 때 | 보는 모델 |
|---|---|
| 따져 묻는 능력이 중요하고 비용을 아끼고 싶다 | 딥시크 |
| 여러 언어, 이미지, 코딩까지 다뤄야 한다 | 큐웬 |
| 안정성과 사용 조건이 중요하다 | Llama |
한 가지 더 덧붙이면, 바닥 단계의 코드는 한 줄도 짤 필요가 없습니다. 신청 팀이 손대는 층은 거의 파이썬 위에서 돌아갑니다. 그 아래쪽은 장비 회사와 클라우드, 오픈소스 쪽에서 이미 다 만들어 놓았습니다.
진짜 신경 써야 할 건
자기 자료, 자기 분야의 규칙, 자기 시스템입니다.
받고 나서 부딪히는 진짜 문제
누군가는 모델을 띄워야 하고, 자기 분야 자료를 정제해야 하고, 이어붙이는 흐름을 짜야 하고, 끝까지 운영도 가져가야 합니다. 그런데 개발자는 대기업이 거의 다 데려갔고, 앞뒤를 한꺼번에 묶어 만들어줄 팀은 더 드뭅니다. 장비를 받고 환경을 갖추고 나면 바로 이 벽과 마주합니다.
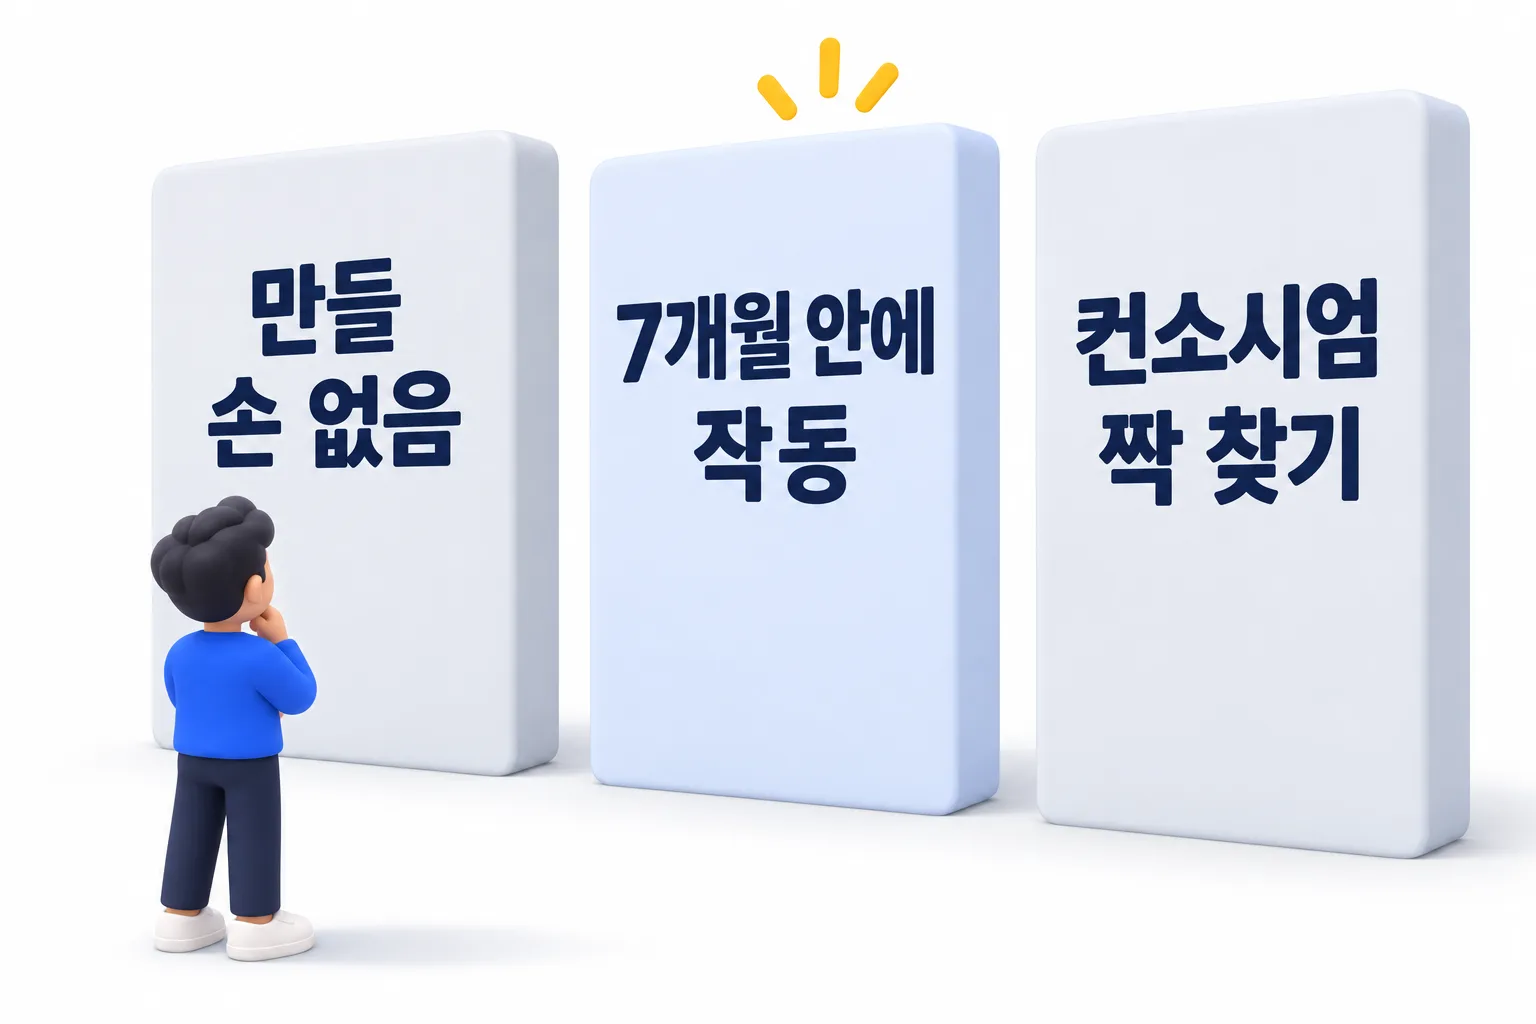
무상 사용은 연말까지입니다. 여름에 받으면 실제 주어진 시간은 대여섯 달 남짓. 이 안에 맛보기 수준이 아니라 실제로 굴러가는 시스템까지 가야 합니다. 거기까지 못 가면 이후에는 사용료가 시장가로 청구됩니다.
혼자 넣을 수 있는 갈래가 사실상 없습니다. 누구와 짝을 지을지, 누구의 자료를 쓸지, 누가 시스템을 만들고 누가 운영할지, 이 역할 분담이 신청서의 절반입니다.
무상인 건 장비이지,
시간이 아닙니다.
준비한다면 이 순서로
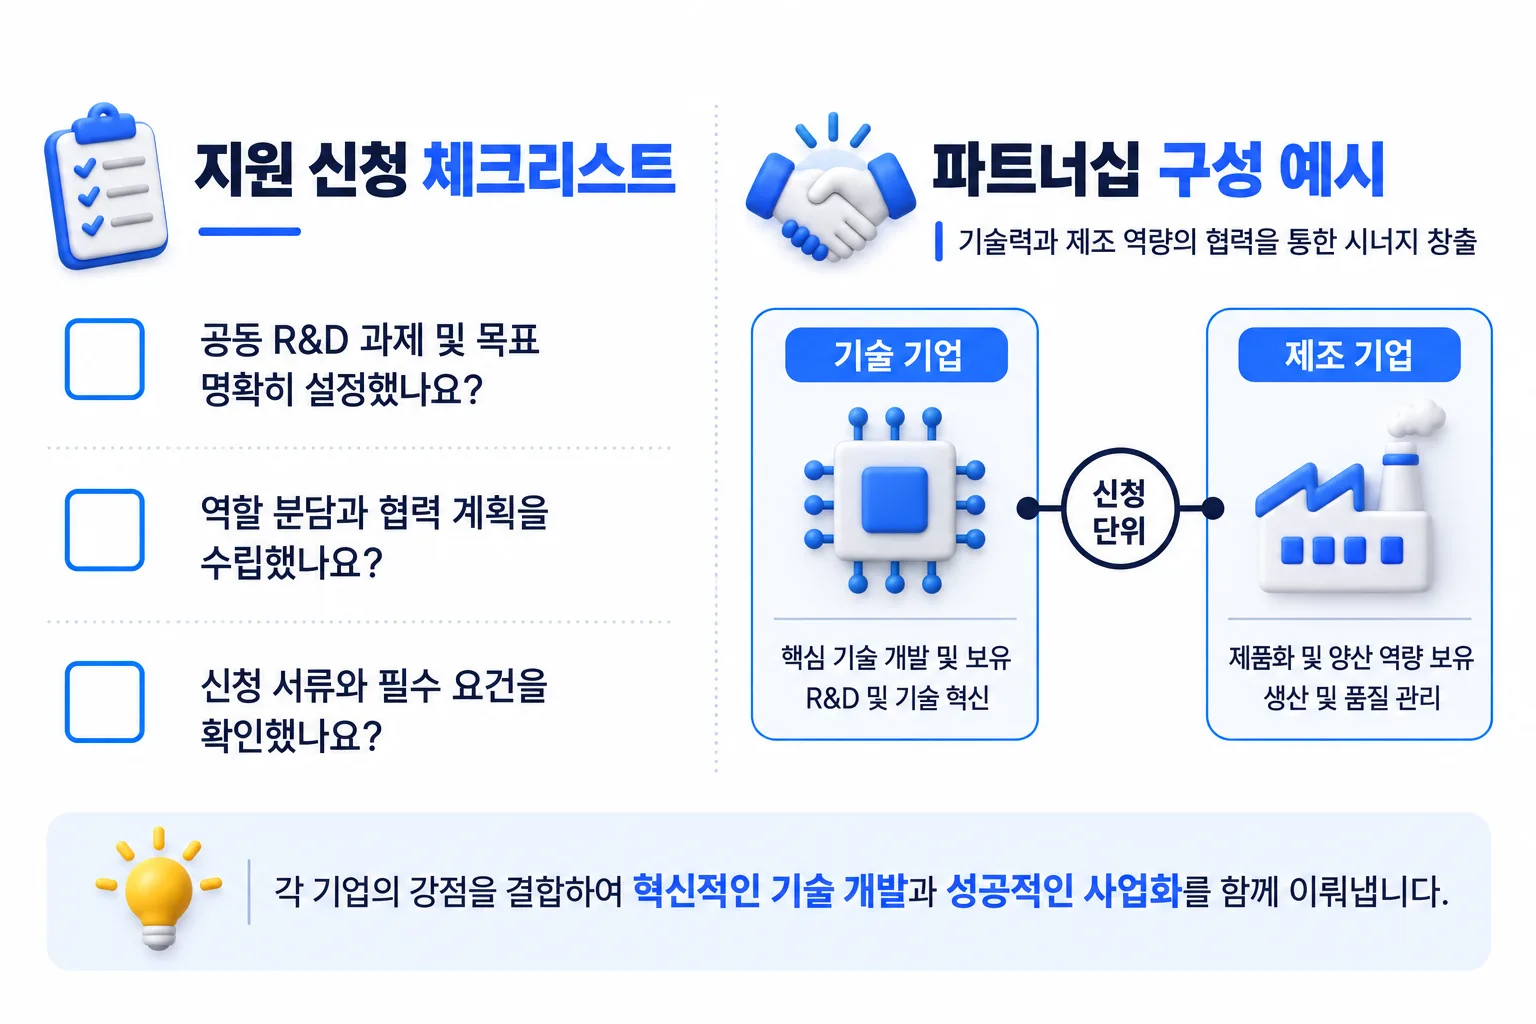
제조 회사인데 도입이 필요하면 기술 파트너를 찾고, 기술 회사라면 제조기업과 손을 잡는 그림입니다. 대학과 협업이 가능하면 핵심 기술 갈래를, 1인이나 예비 단계라면 별도 배정된 자리가 출발점입니다.
장비 받고 나서 모델 고르기 시작하면 늦습니다. 모델 크기가 할당량과 맞는지, 회사 안에 붙여 쓸 자료가 충분한지도 함께 짚어야 합니다.
신청 단위가 여럿인 이상 미리 짝을 찾고 함께 서류를 쓰는 일정이 가장 안전합니다. 공고가 올라오는 즉시 마감일부터 확인하십시오.
신호는 왔습니다
장비는 정부가 준비했고, 모델은 오픈소스에 이미 나와 있고, 돌아갈 자리도 깔려 있습니다. 그런데도 결국 만드는 건 팀의 몫입니다.
지방과 중소기업, 초기 단계에서 인공지능을 자기 산업에 붙이려는 팀이 가장 먼저 부딪히는 벽은 하나로 요약됩니다. 자원은 손에 들어왔는데 만들 손이 부족한 순간.
저희는 "견적 같이 짭시다"가 아니라
"같이 만듭시다"라고 말합니다.
같은 시기에 나온 지역 창업 지원 발표는 지방에서 AI 창업, 받을 수 있는 것에 정리해 두었습니다.
자주 묻는 질문
01정부가 중소기업과 벤처기업에 푸는 GPU 264장은 어떻게 쓰는 것입니까
칩을 사무실로 받는 것이 아니라 클라우드 계정으로 원격 접속해 쓰며, 선정되면 연말까지 무상입니다. 새 AI를 발명하라는 것이 아니라 오픈소스 모델을 띄워 자기 업무에 끼워 쓰라는 자원입니다.
02GPU 지원은 어떤 갈래로 나뉩니까
AI 자동화 과제 64장, 초격차 핵심 기술 개발 85장, 초격차 산업 특화 85장, 모두의 창업 별도 배정 30장입니다. 모든 갈래가 혼자가 아니라 둘 이상이 묶여 받는 구조여서 누구와 짝을 짓느냐가 신청서의 절반을 차지합니다.
03264장으로 새 AI 모델을 처음부터 학습할 수 있습니까
널리 쓰이는 모델을 처음부터 학습하려면 장비가 수만 장 필요하므로 불가능합니다. 가장 큰 비중은 오픈소스 모델에 회사 문서를 붙여 답하게 하는 방식이고, 그다음이 여러 단계를 스스로 처리하는 구조, 일부가 모델을 가볍게 더 학습시키는 방식입니다.
04어떤 오픈소스 모델을 고르면 됩니까
따져 묻는 능력이 중요하고 비용을 아끼려면 딥시크, 여러 언어와 이미지, 코딩까지 다루려면 큐웬, 안정성과 사용 조건이 중요하면 Llama를 봅니다. 장비를 받은 뒤 고르면 늦으므로 모델 크기와 할당량, 붙일 자료가 충분한지 미리 확인합니다.
05GPU를 받은 뒤 부딪히는 문제는 무엇입니까
모델을 띄우고 자료를 정제하고 운영까지 맡을 개발 인력이 부족하고, 무상 사용이 연말까지라 여름에 받으면 대여섯 달 안에 실제로 돌아가는 시스템까지 가야 합니다. 그 뒤에는 사용료가 시장가로 청구됩니다.